Aller au contenu
Maël RobertHubdock — étude de cas
Tous les projetsEn ligne · actif
Projet personnel · veille IA

Hubdock

Une plateforme de veille pour découvrir les modèles, outils et nouveautés IA, alimentée par des sources collectées en continu.
Conception produit et développement full-stack — Maël Robert

Format
Projet personnel · veille IA
Technologies
SvelteKitTypeScriptFastAPIPostgreSQL
https://hubdock.fr
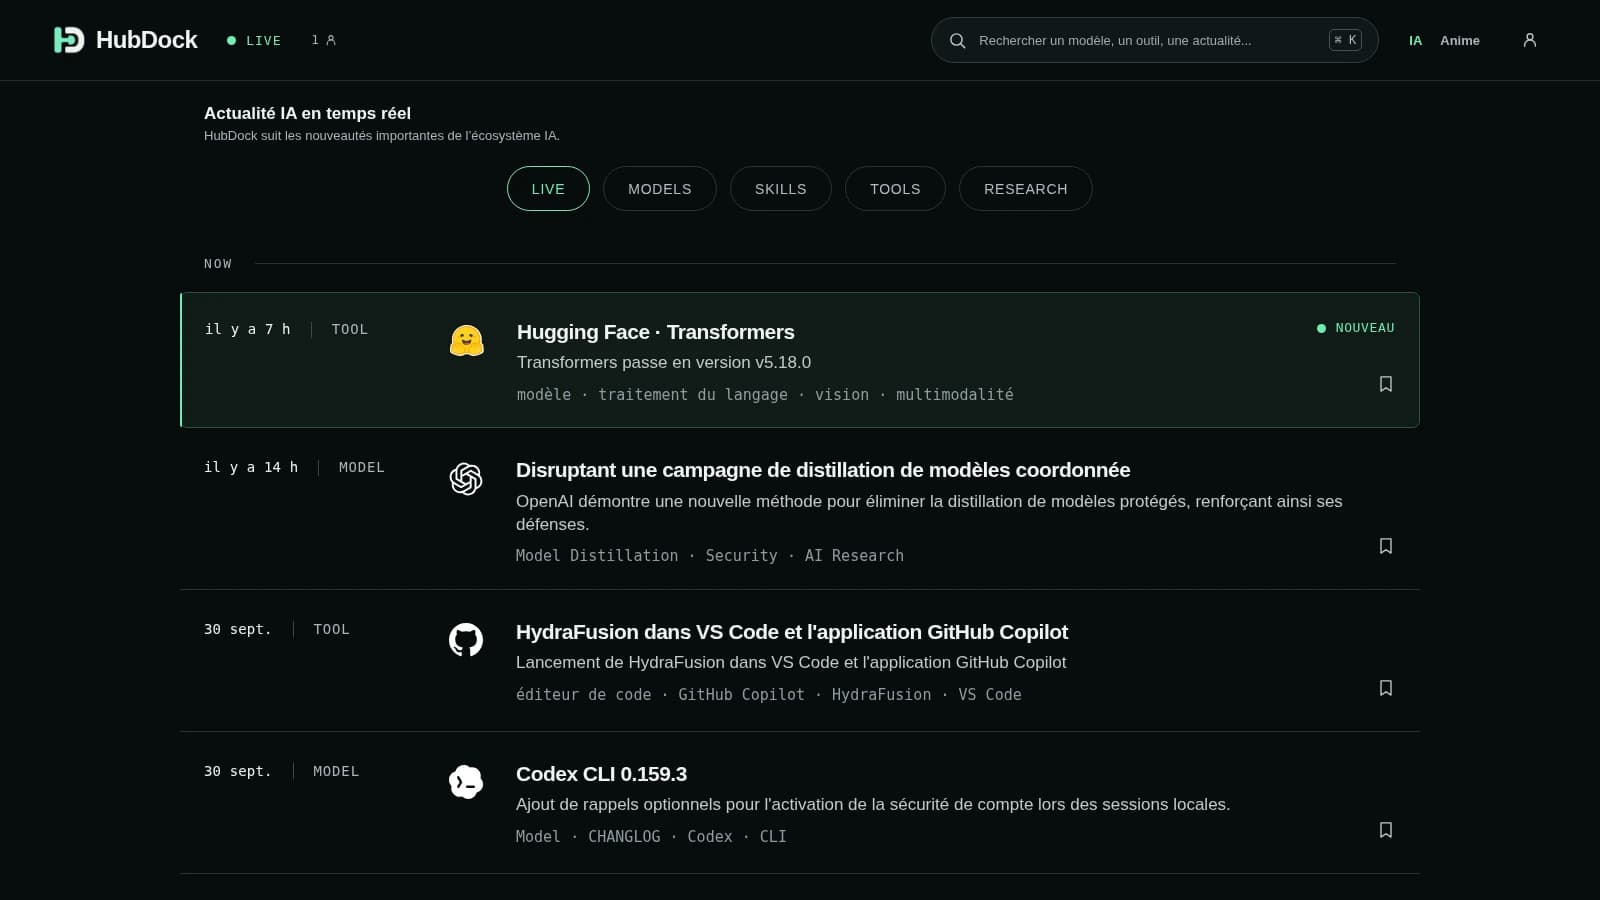
Aperçu de Hubdock
Aperçu principal

Suivre l’IA sans courir après chaque annonce.

L’écosystème IA avance vite : nouveaux modèles, outils, publications et releases se croisent sur une multitude de plateformes. J’ai créé Hubdock pour réunir ces informations, les structurer et permettre de comprendre ce qui change, avec un accès direct aux sources. Le produit se nourrit d’une veille automatisée plutôt que d’un catalogue entretenu à la main.

De l’enjeu à la solution.

01

Problématique

Une annonce importante peut se perdre entre un blog officiel, une release GitHub et un nouveau modèle sur Hugging Face. Les doublons et le rythme de publication compliquent aussi la lecture. Le besoin : une veille continue, consultable et sourcée.
02

Solution

Un flux d’actualités classées, des fiches de synthèse avec leurs sources, une recherche hybride et un espace de découverte des skills. Les comptes permettent de conserver des favoris ; un univers Anime applique déjà cette logique de découverte à un autre domaine.
03

Mon rôle

Je conçois le produit et les parcours UI/UX, développe l’interface et l’API, structure les données et intègre les sources. Je prends aussi en charge les workers de collecte, le traitement IA local, l’authentification, les favoris, les tests et le déploiement. Hubdock est un projet personnel que je continue de faire évoluer.

Découvrir, comprendre et retrouver.

Un flux IA actualisé

Modèles, outils, recherche et évolutions de produits sont rassemblés dans des vues dédiées. Les nouveautés publiées remontent dans l’interface via Server-Sent Events, avec leurs dates, catégories et repères.

Une recherche hybride

La recherche combine le texte intégral de PostgreSQL et la proximité sémantique avec pgvector. Elle permet de retrouver une actualité à partir d’un nom de produit ou d’un sujet.

Des fiches reliées aux sources

Chaque actualité détaille la nouveauté, les produits concernés et les sources originales. Les synthèses françaises facilitent la lecture sans remplacer les publications citées.

La découverte des skills

Des dépôts GitHub sont collectés, enrichis et classés par usages : agents, MCP, workflow, développement ou design. Des vues récentes, populaires et tendances complètent les filtres et la recherche du catalogue.

Des favoris liés au compte

La connexion par e-mail et mot de passe permet d’enregistrer actualités, skills et animes. Les favoris sont conservés côté serveur et retrouvés dans un espace personnel.

Un univers Anime déjà accessible

Un second espace propose tendances, nouveautés, calendrier de diffusion et fiches détaillées. Des filtres, une recherche et des repères sur la version française complètent la découverte, selon les informations disponibles dans les sources.

De l’interface aux sources.

Interface

SvelteKit · Svelte 5 · TypeScript · Server-Sent Events

API et données

Python · FastAPI · SQLAlchemy · PostgreSQL · pgvector · Alembic

Comptes

Better Auth · sessions serveur · favoris PostgreSQL

Veille et IA

workers Python · collecteurs HTTP / RSS · llama.cpp · FastEmbed

Déploiement et qualité

Docker Compose · Cloudflare Tunnel · pytest · Vitest · Playwright

Du flux à la découverte détaillée.

Une veille utile se construit aussi en coulisses.

Collecter dans la durée

Des collecteurs suivent flux RSS, releases GitHub, catalogues Hugging Face, arXiv et changelogs officiels. Un ordonnanceur gère priorités, intervalles, verrous et reprises après échec. Les données brutes sont conservées avant leur traitement, pour garder la trace de chaque source.

Structurer sans inventer

Un worker distinct filtre les informations puis interroge un modèle local via llama.cpp. Sa sortie JSON est validée : catégorie, titre, synthèse française et entités doivent rester ancrés dans la source. Les données de démonstration sont exclues du flux public.

Regrouper les annonces liées

Les embeddings et pgvector rapprochent les contenus susceptibles de décrire le même événement. Des règles sur les entités, versions et dates encadrent la fusion. Les liens vers les sources restent associés à la fiche publiée.

Relier traitement et lecture

L’API sert les contenus structurés, la recherche combine classement textuel et similarité, et les événements SSE actualisent le flux. L’authentification et les favoris passent par SvelteKit ; le traitement de collecte et d’enrichissement reste dans les workers Python.

Une veille qui continue de grandir.

Hubdock est en ligne et développé de manière continue. La collecte, les synthèses et le classement sont progressivement affinés. Les prochaines évolutions visent à élargir les sources et à améliorer la pertinence de la découverte. Cette fiche décrit les fonctionnalités actuelles, sans figer la suite du produit.